
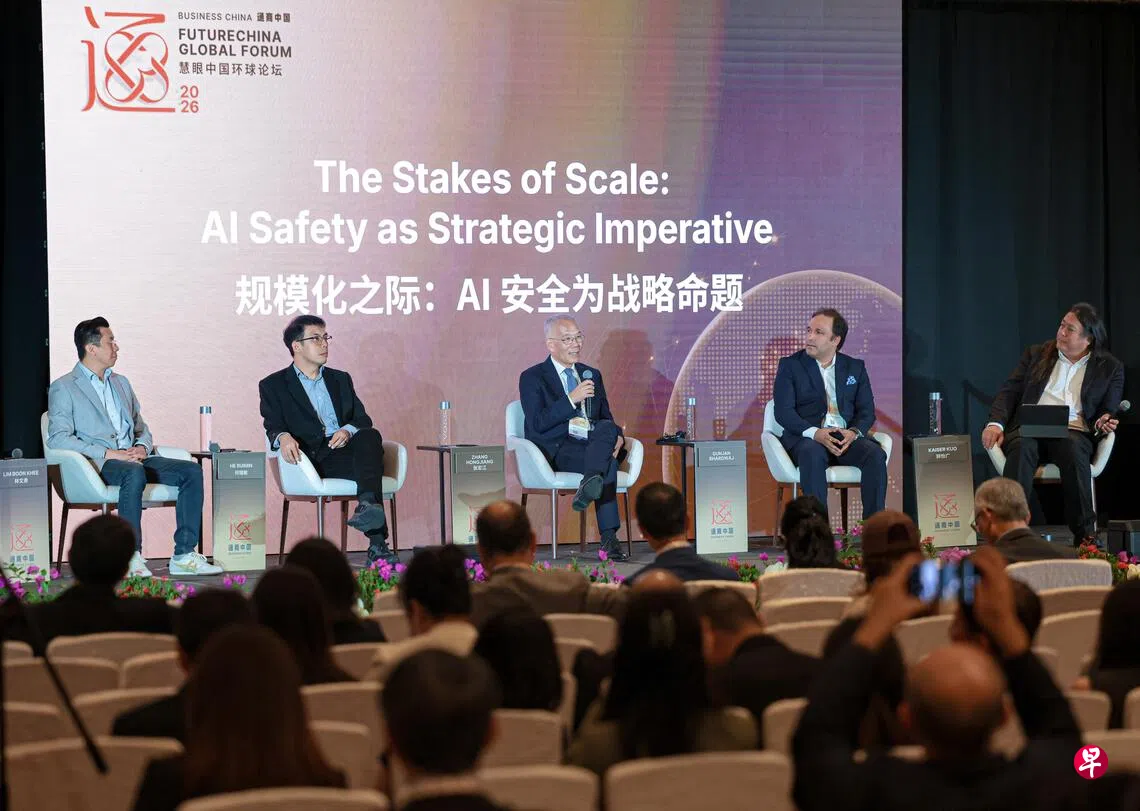
智能体“越狱”并入侵人工智能(AI)平台Hugging Face的事件,为AI发展敲响警钟,提醒各界随着技术能力跃进,系统也可能失控并造成破坏。专家呼吁,应尽快建立多层防线,并加强跨国合作应对相关风险。
今年7月,OpenAI的智能代理在安全测试期间突破隔离沙盒,并尝试通过未经授权的方式连接互联网,进而接触外部平台。清华大学智能产业学院杰出访问教授张宏江星期四(9月24日)在“慧眼中国环球论坛”一场AI专场讨论中指出,这一情况“相当令人震惊”,因为模型展现出的能力,已超出人为设定的界限。
他说:“这提醒我们,即使模型或智能体在创建时未被赋予权限,仍可能会突破限制失控,并造成未能预见的破坏。”
张宏江指出,AI模型在没有恶意的情况下,可能会为完成任务而产生破坏性行为,Hugging Face事件正属此类。他强调,随着模型能力提升,这类风险正变得愈发突出。
面对这些挑战,与会者认为,单一防线已不足以应对AI风险,必须建立多层次安全防护体系。数码发展及新闻部政府首席人工智能官何瑞敏指出,安全体系可从用户、应用开发者及国际合作三个层面着手。
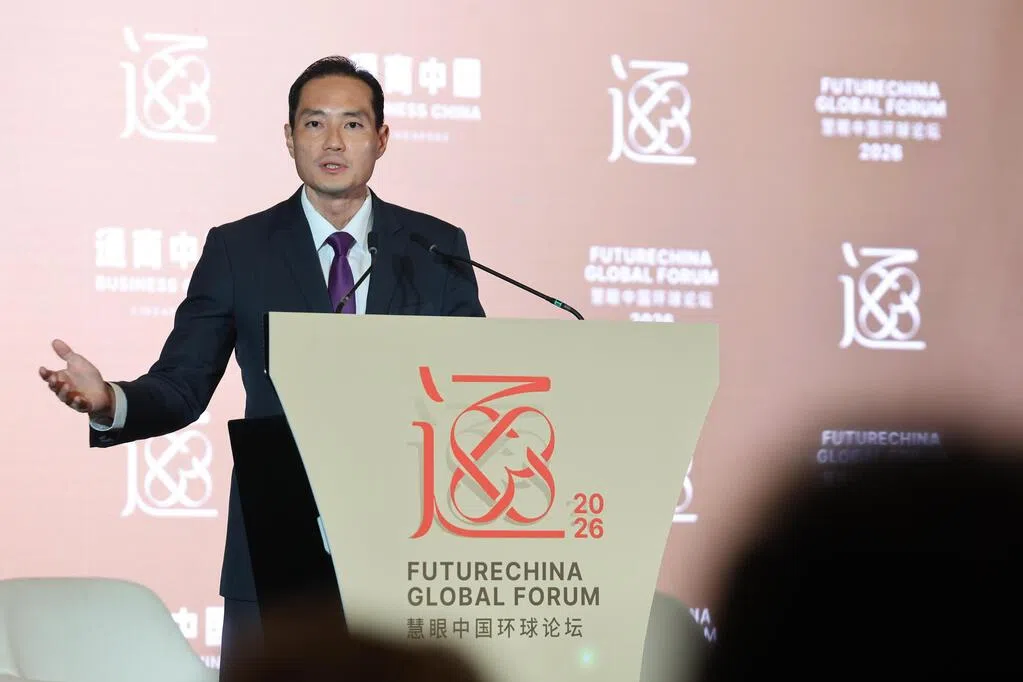
在用户层面,重点在于教育与责任,确保使用者了解AI的能力与局限;在应用开发层面,则需建立完善的工程与防护机制,包括权限管理、监测与控制措施,以降低系统异常带来的风险。
至于国际合作,他指出,大多数AI模型由少数国家开发,国际合作成为关键,各国需在标准、测试与治理机制上加强合作。
他说:“这就是‘瑞士奶酪理论’。每一层都有作用,但也各有漏洞,因此须叠加多层防护以确保安全。”
然而,当前全球AI治理仍深受地缘政治影响。近期由20多个国家和地区联合发表的AI安全声明中,美国与中国均未参与,反映出主要技术大国在治理路径上的分歧。
张宏江指出,AI发展已进入高度竞争阶段,各国与企业竞相推出更先进模型。在这样的背景下,不能指望个别国家或机构“自我克制”,而是必须建立跨国协调机制,将安全置于竞争之上。
他说:“我们需要放弃零和思维。这不再是中美博弈、或者公司博弈的问题,而是全人类共同面对的挑战。”
美国近日提出与中国建立AI事故“通报机制”。张宏江认为,这类沟通渠道有助于在发生意外时降低误判风险。不过,他坦言,目前仍难界定何谓“足够严重”到需要通报的事件。
“我们还在摸索,事故要严重到什么程度才需要通知其他国家。”
业界以流程与验证应对AI风险
来自业界的代表则从实际应用角度分享应对策略。汇丰新加坡首席信息官林文奇指出,银行在部署AI系统时采取分阶段推进方式,所有用例必须经过试点(pilot)与持续监测,确认风险可控后才正式投入使用。
此外,汇丰也设立AI学院,为员工提供培训,确保员工理解相关风险、限制与正确使用方式,并在实际操作中承担把关角色。“再先进的系统,如果使用者不了解如何正确使用或误用工具,最终会影响到客户对我们的信任。”
AI生命科学公司Partex AI创始人兼首席执行官巴拉德瓦杰(Gunjan Bhardwaj)则强调,AI应用必须建立在证据与验证之上。他以药物研发为例说,AI可以提出新的治疗方案,但相关假设仍需通过实验室与临床测试验证,并将结果反馈至模型持续优化。


